標準正規分布表の見方と使い方完全ガイド!Z値計算から確率の求め方まで徹底解説
統計学の基礎からデータサイエンスの現場、さらには統計検定対策に至るまで、必ずと言っていいほど直面するのが「標準正規分布表の読み取り」です。しかし、参考書や試験問題によって表の定義が異なっていたり、「上側確率」「下側累積確率」の区別がつかなくなったりして、計算ミスをしてしまう受験生や実務担当者が後を絶ちません。
本稿では、標準正規分布表の構造的な見方やZ値の計算公式、信頼区間の導出法、さらにはExcel関数の活用術までを体系的に整理しました。試験本番で迷わず正確な数値を導き出すための実践テクニックを余すところなく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:標準正規分布は「平均0・分散1」に変換した対称な確率分布であり、表の種類(上側確率型・下側累積型)を見極めることが読み取りの第一歩。
- 要点2:Z値の標準化公式「$Z = (X - \mu) / \sigma$」を正しく適用し、対称性を利用して負の値や両側確率を柔軟に変換・算出する。
- 要点3:95%信頼区間の基準値「1.96」やExcelの「NORM.S.DIST」関数の挙動を把握することで、試験対策と実務運用の双方が盤石になる。
標準正規分布表の基本構造|平均0・分散1の対称グラフを理解する
統計学における正規分布は、自然現象や社会データの多くが従う釣鐘型の美しい曲線を描きます。しかし、平均値($\mu$)や標準偏差($\sigma$)は扱うデータごとに異なるため、そのままでは確率の計算が極めて煩雑になります。そこで用いられるのが、あらゆる正規分布を平均0、分散1(標準偏差1)の状態へと変換した「標準正規分布」です。
標準正規分布の確率密度関数グラフは、$Z = 0$ を中心にして左右完全対称の形をしています。曲線全体の面積(全確率)はちょうど「1.0」であり、中心である $Z = 0$ より右側の面積は「0.5」、左側の面積も「0.5」となります。標準正規分布表は、このグラフの特定領域の面積(=確率)をあらかじめ数値として一覧化したものです。
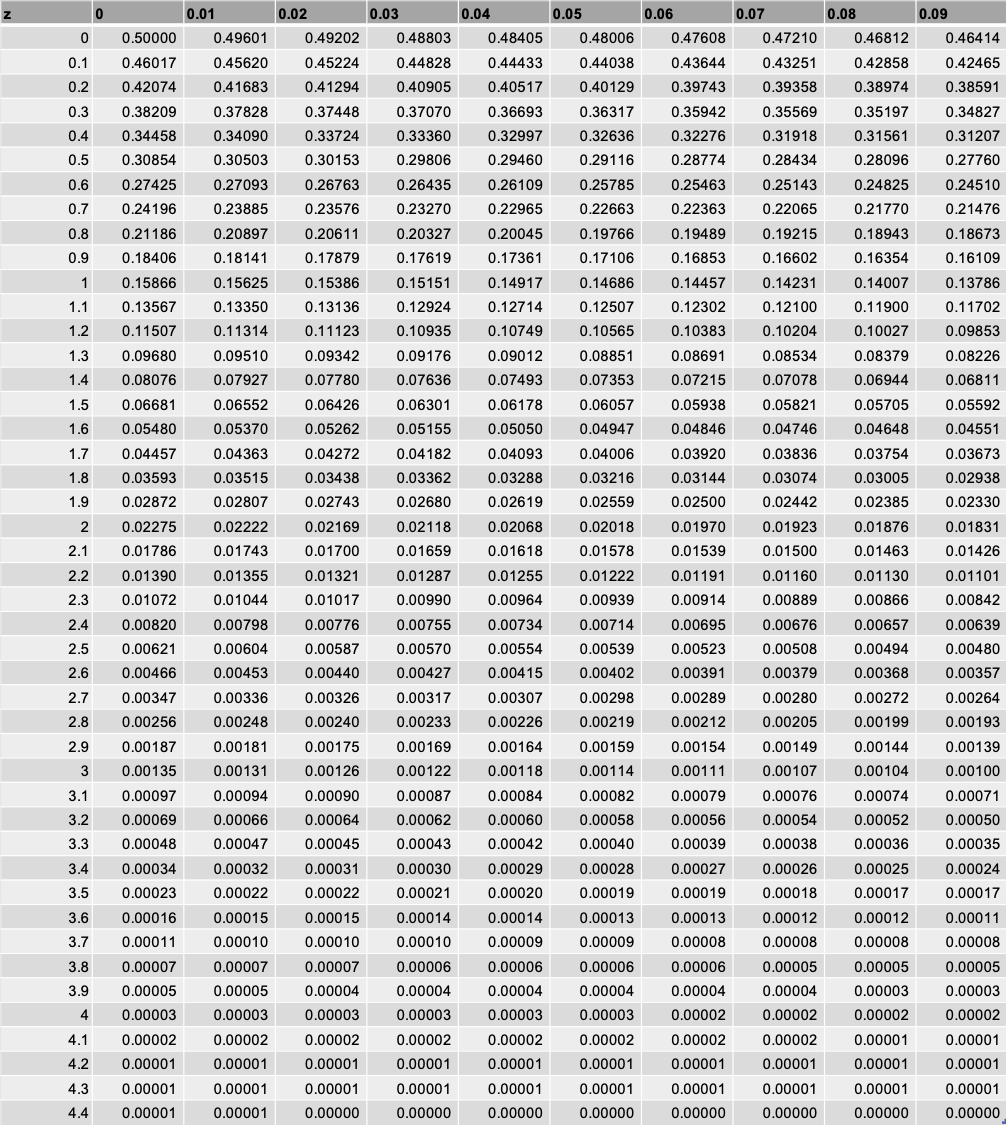
【決定版】標準正規分布表の見方と使い方|上側確率・両側確率の読み取り手順
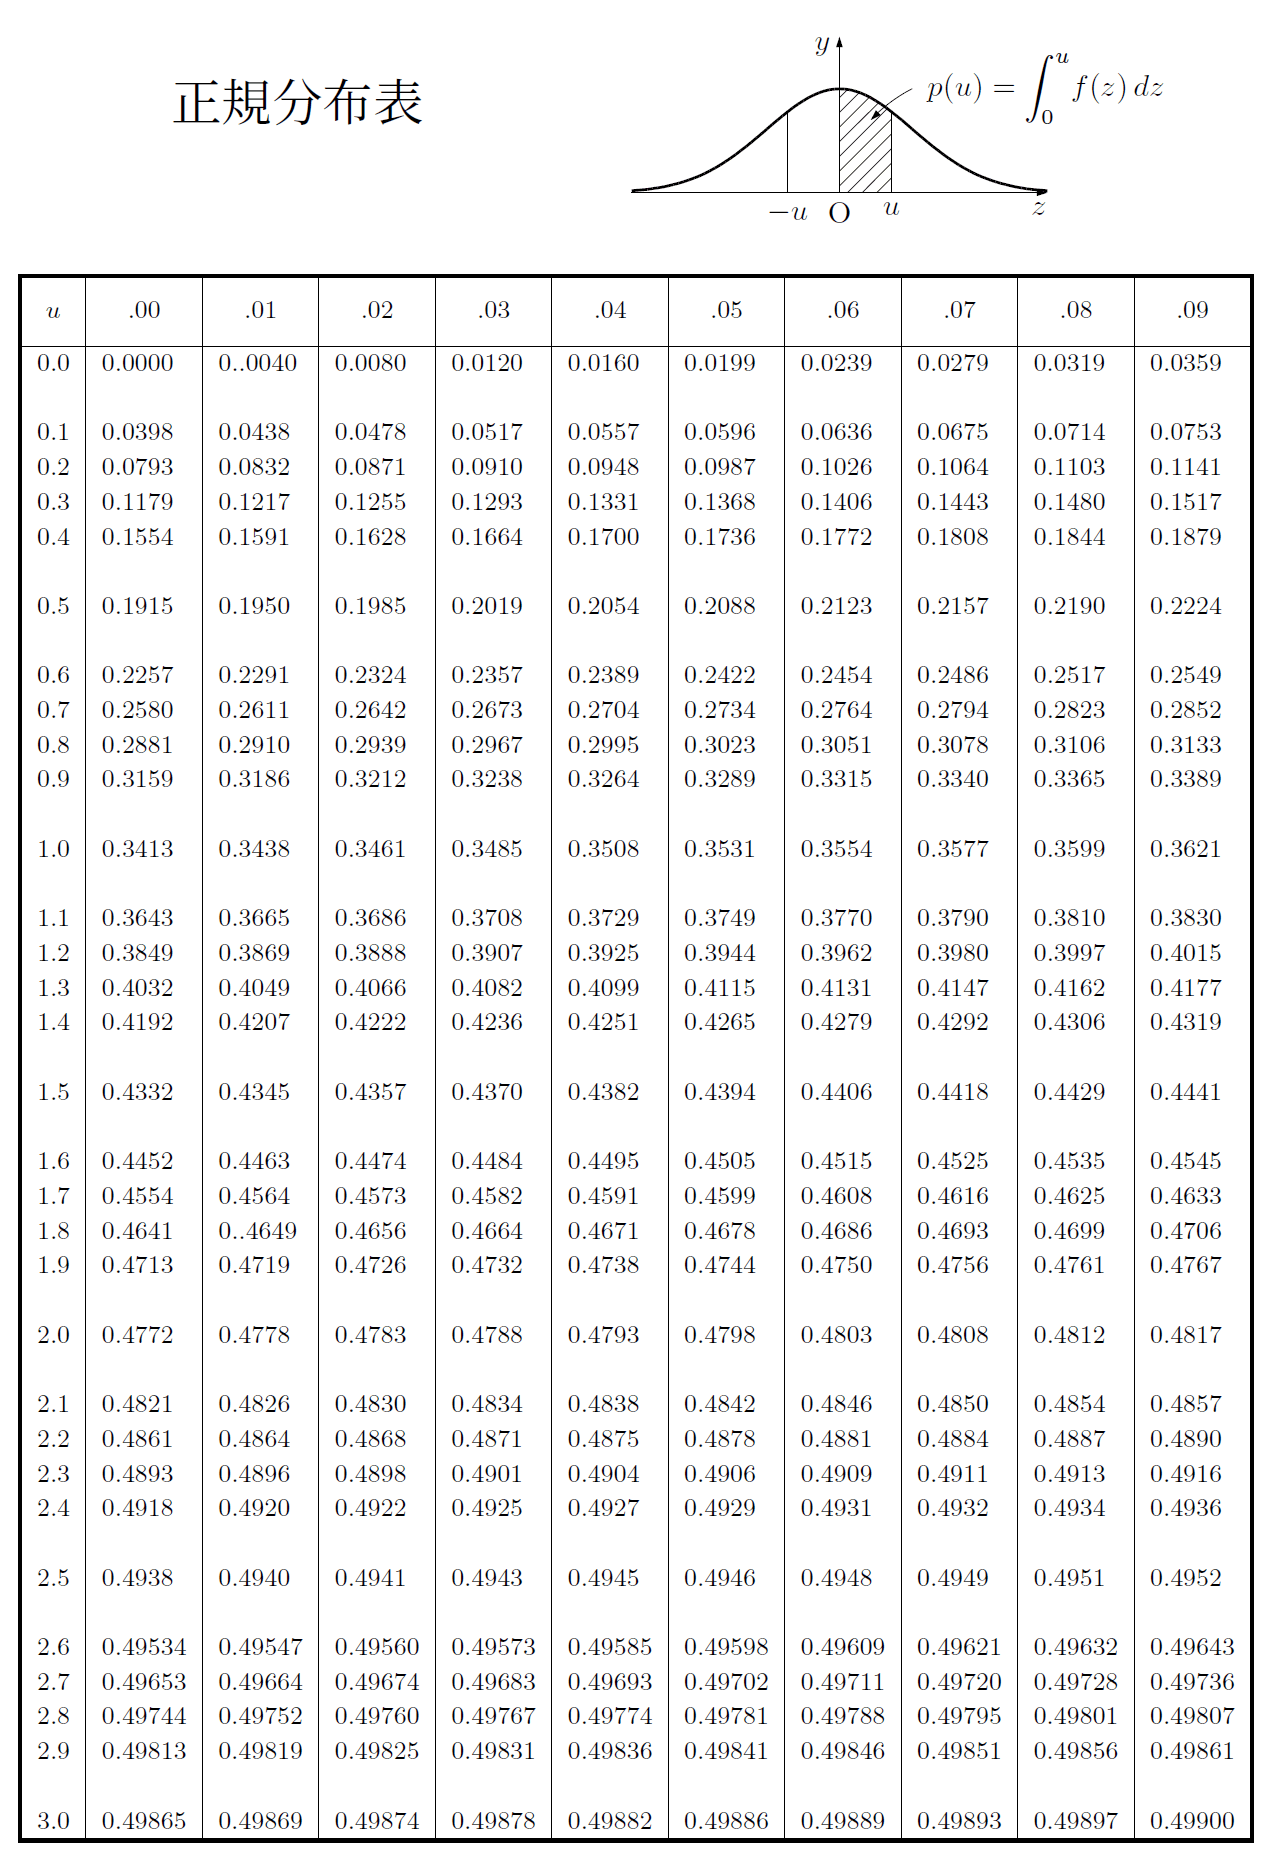
試験問題や専門書で標準正規分布表を扱う際、最も注意すべき点は「その表がどの領域の確率を示しているか」という定義の確認です。日本国内の統計学テキストや統計検定の付表では、主に以下の3パターンが存在します。
| 表のタイプ | 表されている領域(定義) | 主な掲載媒体・用途 | 読み取り時の注意点 |
|---|---|---|---|
| 上側確率型($P(Z \ge z)$) | 指定した $z$ より右側のすそ野の面積 | 統計検定公式付表、多くの大学教科書 | 下側確率を求める際は「$1 - P$」で計算する |
| 下側累積確率型($P(Z \le z)$) | マイナス無限大から $z$ までの全面積 | Excel関数、海外テキスト、品質管理(QC) | $z=0$ のとき値は 0.5000 となる |
| 中心確率型($P(0 \le Z \le z)$) | 中心 0 から $z$ までの間の面積 | 一部の工学系・心理統計の専門書 | 上側を求めるには「$0.5 - P$」の引き算が必要 |
標準正規分布表の見出し行と見出し列の交点を探すのが基本操作です。たとえば $Z = 1.96$ の上側確率を求めたい場合、行ラベルで「1.9」を探し、列ラベルで「0.06」を探して交差するセルの値を読み取ります。上側確率型の表であれば、そこには「0.0250(2.5%)」という数値が記載されています。
Z値の計算公式と標準化の手順|具体例でマスターする変換テクニック
手元の測定データ($X$)を標準正規分布表で引くためには、データをZ値に変換する「標準化(正規化)」が必要です。標準化公式は非常に明快です。
$$Z = \frac{X - \mu}{\sigma}$$
ここで $X$ は測定値、$\mu$ は母平均、$\sigma$ は母標準偏差を示します。具体例として、ある試験の平均点が60点、標準偏差が10点だった場合に、75点を取った受験生の上位何%に位置するかを求めてみましょう。
公式に当てはめると、$Z = (75 - 60) / 10 = 1.50$ となります。標準正規分布表(上側確率型)で行「1.5」、列「0.00」が交差する位置を読み取ると「0.0668」となります。すなわち、75点以上の受験生は約6.68%(上位6.7%以内)に位置していることが判明します。

【実態検証】統計検定や大学講義でつまずく受験生・学習者のリアル
SNSや学習コミュニティ、Q&Aサイトを調査すると、標準正規分布表の読み取りで失点するパターンには明確な共通点があります。最も典型的なつまずきポイントは「$Z$ が負の値になったときの処理」と「両側確率の扱い」です。
標準正規分布表には通常、$Z \ge 0$ の正の値しか記載されていません。そのため、たとえば $Z = -1.5$ 以下の確率を求めたい場合、グラフの対称性を思い出し「$P(Z \le -1.5) = P(Z \ge 1.5)$」と脳内で反転させる必要があります。この対称変換のイメージが定着していないと、マイナスの記号を見た瞬間に手が止まってしまいます。
また、仮説検定における「有意水準5%の両側検定」では、左右両方のすそ野を合わせて5%にする必要があるため、片側あたりの面積は「2.5%(0.025)」になります。このとき探すべきZ値が「1.96」であることを丸暗記で済ませてしまい、片側検定の際にも誤って1.96を適用してしまうミスが多発しています。
一般に知られていない盲点とネットの誤解
ネット上の簡易解説記事などで頻繁に見られる誤解が、「標準正規分布表の確率値はどれも同じようにそのまま使える」という思い込みです。先述の通り、表の掲載形式が異なれば、表中に書かれている数字の意味は180度変わります。
統計検定のCBT方式試験や各大学の定期試験では、配布される付表の左上に必ず「網掛けされた分布の図」が掲載されています。表を読み始める前に、まず「網掛けが右端(上側)にあるのか」「左端から累積しているのか」を確認する習慣をつけてください。この数秒の確認を怠ることが、符号の取り違えや確率の計算間違いを引き起こす最大の要因です。
【プロの結論】エクセル関数活用と手引き計算の使い分け判断基準
実務と学習の双方を効率化するために、手計算(数表)とソフトウェアの役割分担を明確にしておくことが不可欠です。
Excel上で標準正規分布の確率を求める場合、現代の標準関数である「NORM.S.DIST」を使用します。この関数は引数に「TRUE」を指定すると下側累積確率 $P(Z \le z)$ を返します。たとえば「=NORM.S.DIST(1.96, TRUE)」と入力すると「0.975002...」が出力され、上側確率は「=1 - NORM.S.DIST(1.96, TRUE)」で計算可能です。また、確率からZ値を逆算したい場合は「NORM.S.INV」関数を用います。
統計検定2級などの資格試験を受験する方は、数表を手作業で素早く引く訓練が必須です。一方で、マーケティング分析や品質管理の実務現場では、手作業による転記ミスを避けるため、Excel関数やPython(scipy.stats)を活用した自動化を推奨します。
【標準 正規 分布 表】に関するよくある質問(FAQ)
Q1:なぜ統計検定の表には 1.96 や 2.58 という数値がよく登場するのですか?
A1:これらは仮説検定や信頼区間推定で極めて重要となる基準値だからです。上側確率が2.5%(両側で5%)となる境界値が「1.96」、上側確率が0.5%(両側で1%)となる境界値が「2.576(四捨五入して2.58)」に対応しています。95%信頼区間や99%信頼区間を構成する際の基本定数として定着しています。
Q2:正規分布表で探したい確率が表の値と値のちょうど中間にある場合はどうすればいいですか?
A2:試験問題の指示に従いますが、一般的には最も近いZ値を採用するか、2つの値の間を比例配分して近似する「線形補間(補間法)」を行います。厳密な精度が求められない検定問題では、より安全側(保守的)な値または直近の値を採用することが通例です。
Q3:標本平均の標準化を行うとき、公式の分母はどう変わりますか?
A3:個別のデータ $X$ ではなく、サンプルサイズ $n$ の標本平均 $\bar{X}$ を標準化する場合は、中心極限定理に基づき標準偏差の代わりに標準誤差($\sigma / \sqrt{n}$)を用います。公式は $Z = (\bar{X} - \mu) / (\sigma / \sqrt{n})$ となり、分母に $\sqrt{n}$ が入る点に注意してください。
まとめ:今後の動向と失敗しないための判断基準
標準正規分布表の読み取りは、一見すると単なる数値の照合作業に見えますが、その背後にある「確率密度関数の対称性」や「標準化の意義」を深く理解していなければ、検定方式の変化や負の値の処理で容易にミスを誘発します。
まずは付表のグラフ形状(上側か累積か)を必ず確認し、Z値の標準化公式を手を動かして定着させましょう。グラフを描いて求めたい面積を視覚化するワンステップを挟むだけで、計算ミスは劇的に削減されます。基礎を確実に固め、統計分析の実践や資格試験での確実な得点へとつなげてください。 (出典: 標準 正規 分布 表(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
